
Bu yazıda
OCR, görüntüdeki yazıyı düzenlenebilir metne dönüştürür; çıktının doğru olduğunu garanti etmez. Özellikle Türkçe harfler, birbirine benzeyen rakamlar, virgül/nokta ve satır sırası anlamı değiştirebilir. İyi düzeltme, metni yalnız akıcı hale getirmekle kalmaz; kaynak görüntüyle aynı bilgiyi taşıdığını kontrol eder.
Önce kaynak görüntüyü iyileştirin
Tesseract kalite rehberi, eğiklik, gürültü, görüntü ölçeği ve sayfa düzeninin tanımayı etkilediğini açıklar. Bu nedenle bulanık bir sayfadan tekrar tekrar OCR almak yerine görüntünün okunurluğunu kontrol edin. Kenarı kesilmiş, gölgeli veya döndürülmüş bir belgeyi düzeltmek, sonradan çok sayıda kelime tahmin etmekten daha güvenilir bir başlangıçtır.
Belgenin özgün nüshasını koruyun. Kırpma veya kontrast ayarı yapıyorsanız yalnız çalışma kopyasında ilerleyin; kaybolan bir kenar bilgisini metinden geri kurmaya çalışmayın.
Hataları önem sırasına göre kontrol edin
OCR çıktısında önce kimlik ve ad, tutar ve oran, tarih ve süre, hukuki anlamı değiştiren olumsuzluk ifadeleri ile sayfa ve satır sırası kaynak görüntüyle karşılaştırılmalıdır.
| Alan | Örnek karışıklık | Kontrol yöntemi |
|---|---|---|
| Kimlik ve ad | I/İ/ı/i, O/0, benzer soyadlar | Kaynak görüntüde ilgili satırı büyütün. |
| Tutar ve oran | 1.250,00 ile 125.000 veya % işaretinin kaybı | Rakamları ve ayırıcıları tek tek karşılaştırın. |
| Tarih ve süre | 01/07 ile 07/01 veya eksik yıl | Gün, ay, yıl ve bağlamı birlikte doğrulayın. |
| Hukuki anlam | Olumsuzluk ekinin veya “değil” sözcüğünün düşmesi | Cümleyi kaynakta baştan sona okuyun. |
| Sayfa ve satır sırası | İki sütunun tek cümleye karışması | Paragraf ve sayfa geçişlerini yeniden düzenleyin. |
Yapay zeka düzeltmesi neyi yapabilir, neyi yapamaz?
Bir dil modeli bozuk bir kelime için olası yazımlar önerebilir. Fakat kaynakta olmayan bir tarihi, tutarı veya kişi adını tahmin etmesi doğrulama değildir. “Düzelt” talimatıyla akıcı hale gelen metinde, belgenin anlamını değiştiren bir ekleme de oluşabilir.
Bu nedenle kaynak görüntüde okunamayan alanı belirsiz olarak işaretleyin. Dil bilgisinden tahmin edilen bir sonucu kesin metin gibi kullanmayın. Hassas dosyaları başka bir hizmete aktarmadan önce o hizmetin veri işleme koşullarını ayrıca değerlendirin.
Sitedeki OCR aracı nasıl çalışır?
OCR metin tanıma aracı, Tesseract.js ile tarayıcıda çalışır ve tanınan metni düzenlemenize imkan verir. Bu akışta her belgeyle kendini eğiten bir model veya garanti edilmiş doğruluk yüzdesi sunulmaz. Word, UDF ya da TXT çıktısı alınması da özgün sayfa tasarımının birebir korunacağı anlamına gelmez.
Uygulama ekranında gösterilen dosya türü, boyut ve sayfa sınırlarını yüklemeden önce okuyun. Çok sayfalı PDF'de her sayfanın işlenip işlenmediğini ve metin sırasını ayrıca kontrol edin.
Beş aşamalı düzeltme sırası
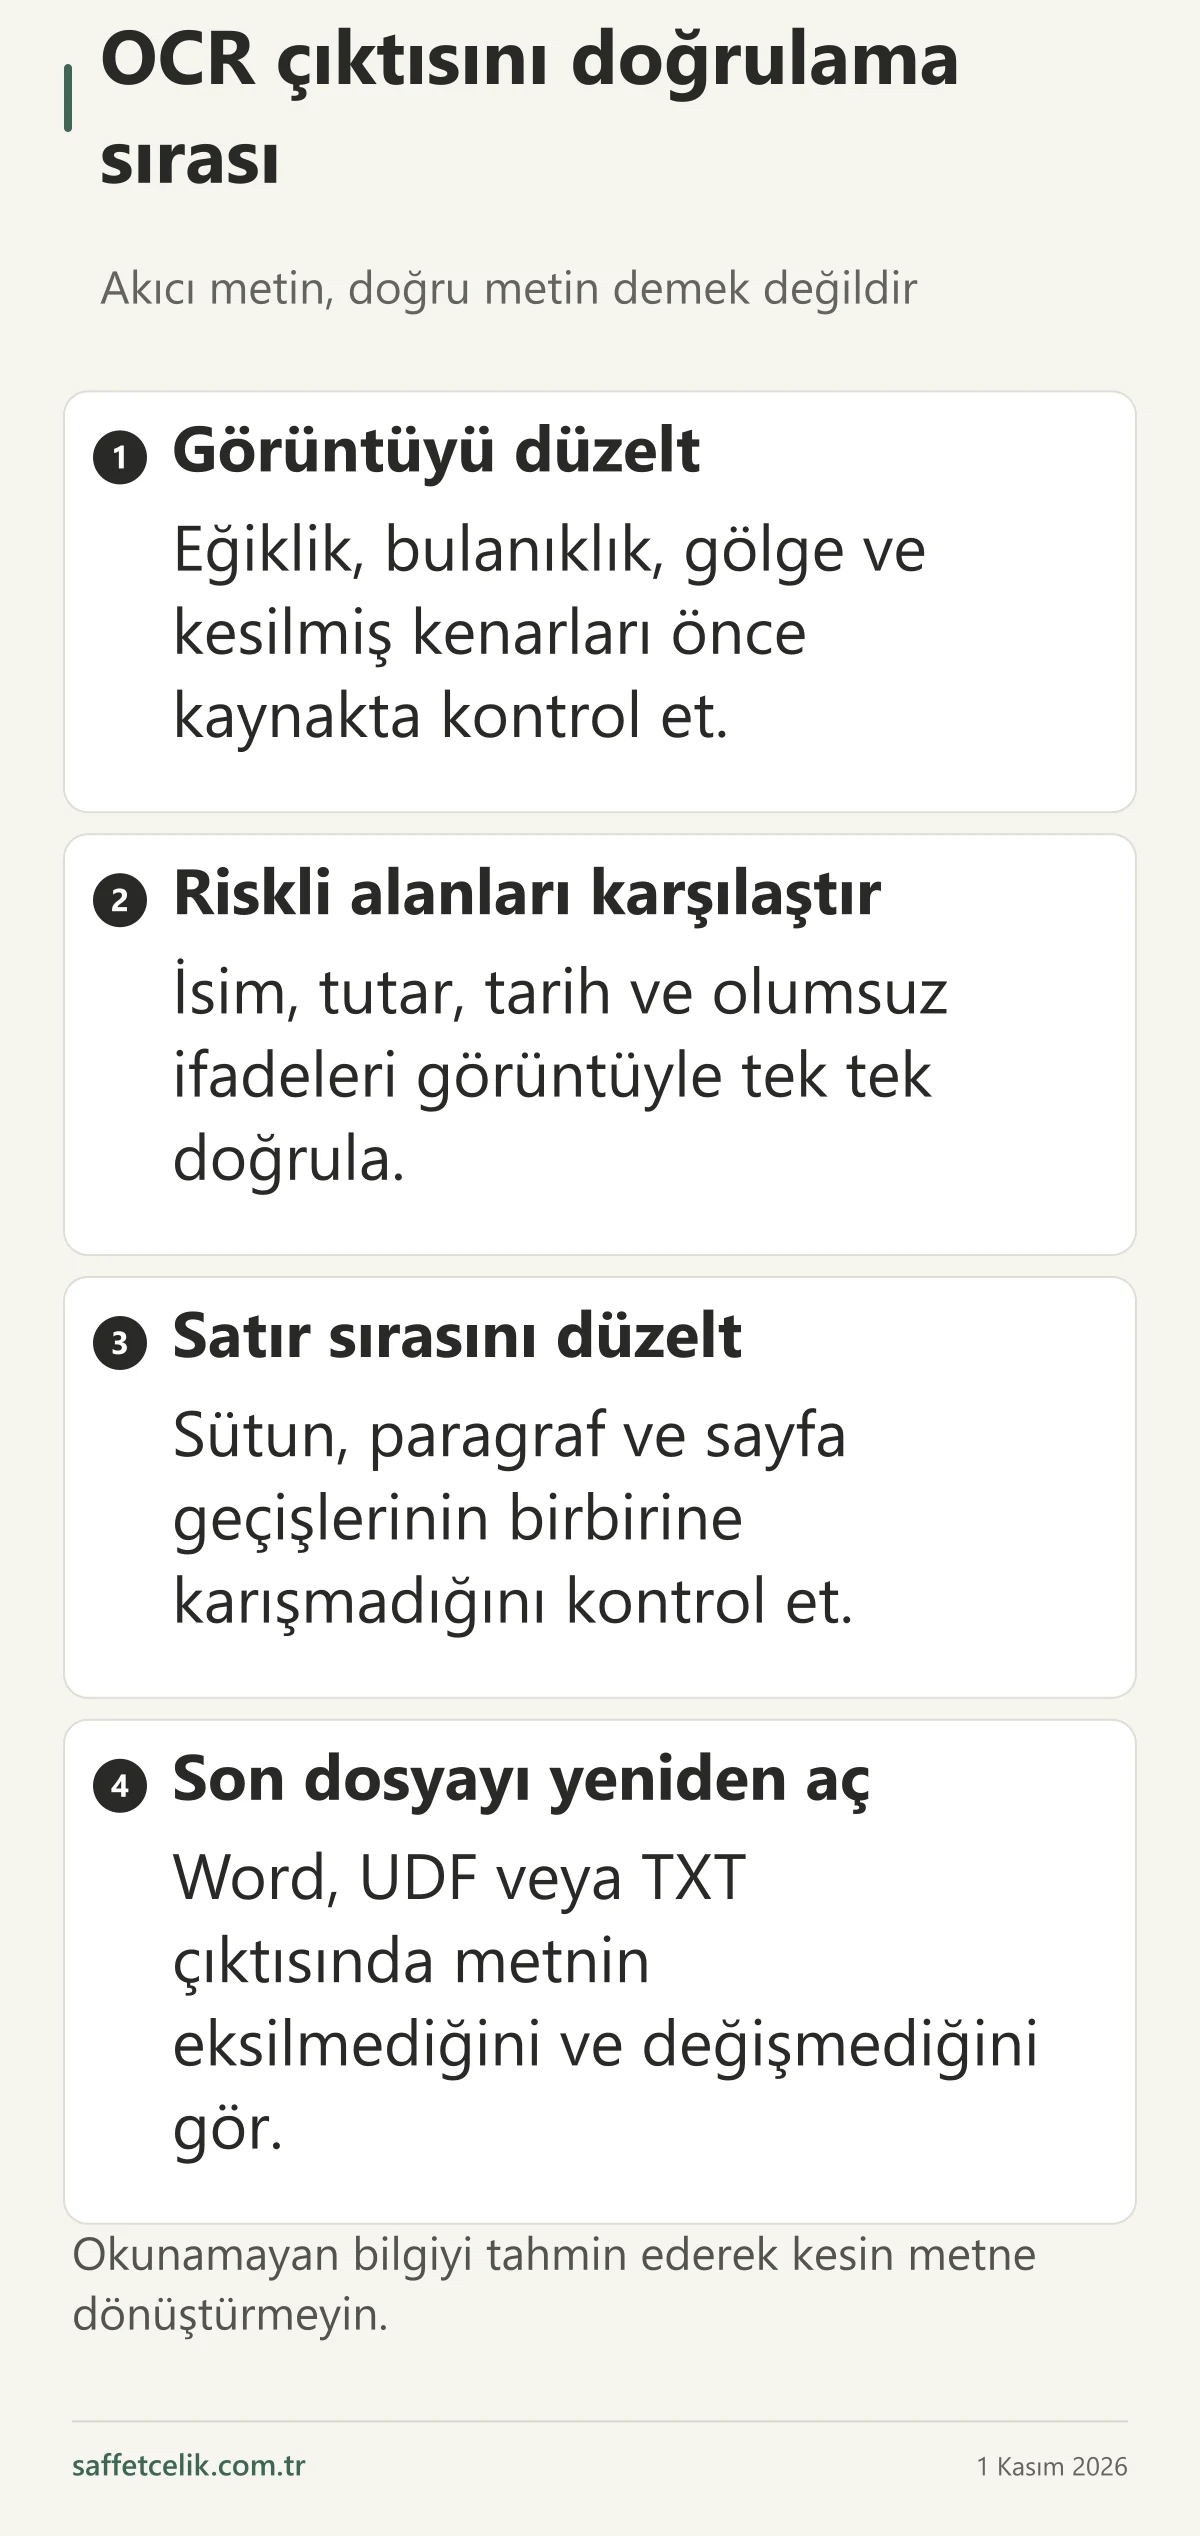
Düzeltme sırası kaynak belgeyi okunur hale getirme, OCR yapma, isim, tutar ve tarihleri görüntüyle karşılaştırma, düzeni toparlama ve dışa aktarılan dosyayı yeniden doğrulamadan oluşur.
- Kaynak belgeyi okunur hale getirin; yön ve sayfa sırasını kontrol edin.
- OCR işlemini yapın ve eksik sayfa olup olmadığını inceleyin.
- İsim, tutar, tarih ve olumsuz ifadeleri görüntüyle karşılaştırın.
- Paragraf, başlık ve tablo sırasını düzenleyin; kaynaktaki bilgi eklenip çıkarılmasın.
- Dışa aktarılan dosyayı yeniden açın. Düzenleme ekranındaki metinle son dosyanın aynı olduğunu doğrulayın.
Nüfus ve aile bilgileriyle çalışıyorsanız anlaşmalı boşanmada belge hazırlığı rehberi, tanınan veriyle hukuki belge arasındaki kontrol aşamasını ayrıca anlatır.
Çıktı çok hatalıysa ne yapılmalı?
Aynı düşük kaliteli dosyada kelimeleri topluca tahmin etmek yerine daha okunur tarama isteyin veya yalnız gerekli bölümün kaynağını kontrol edin. Amaç en hızlı metni değil, doğrulanabilir metni elde etmektir. Düzeltilemeyen alanın açıkça belirtilmesi, güvenilir görünmesine rağmen yanlış bir metinden daha yararlıdır.
Kaynaklar ve kontrol tarihi
Kaynak kontrolü: 1 Kasım 2026.
Kapak görseli yapay zeka ile üretilmiş temsili bir görseldir.
Güncelleme geçmişi
Güncel
Aracın kendi kendine öğrendiği, özel bir model kullandığı ve yüzde 99 doğruluk sağladığı iddiaları kaldırıldı. Tarayıcıda Tesseract.js ile çalışan gerçek iş akışı ve sonucun düz metin olarak aktarılmasının sınırı açıklandı. Türkçe harf, sayı ve olumsuzluk hatalarını kontrol etmek için bir tablo ve Tesseract'ın resmi teknik belgesi eklendi. Başlık, yazının kapsamını daha doğru anlatacak biçimde değiştirildi. Konuyu özetleyen bir infografik eklendi.
Yazı yayımlandı.
Yorumlar (0)
Henüz yorum yok. Bu yazıya ilk yorumu siz yapın!